Geschäftsfeld 04
KI für Entwicklung, Auswertung und Code-Generierung
Wir setzen KI dort ein, wo sie Entwicklungsarbeit messbar beschleunigt: bei der Auswertung von Mess- und Prüfdaten, bei der Generierung von angepasstem Code, und bei der Anbindung von Modellen an die Daten und Werkzeuge, in denen die Arbeit tatsächlich stattfindet. Und wir bauen die Prüfumgebungen, ohne die sich der Nutzen solcher Systeme nicht belegen lässt.
Fine-Tuning und Anpassung von KI-Modellen
Ein allgemeines Modell kennt Ihre Bauteile, Ihre Normen und Ihre Codebasis nicht. Anpassung bringt dieses Wissen hinein.
Der Ausgangspunkt ist die Aufgabe, nicht das Modell: Was soll am Ende messbar besser laufen — die Auswertung eines Prüfprotokolls, die Einordnung von Fehlerbildern, die Generierung von Konfigurations- oder Treibercode? Daraus ergibt sich, ob eine gute Kontextgestaltung genügt, ob ein Retrieval über Ihre eigenen Dokumente die richtige Antwort ist, oder ob es tatsächlich ein feinabgestimmtes Modell braucht. Die drei Wege unterscheiden sich im Aufwand um Grössenordnungen — die Reihenfolge ist deshalb kein Detail.
Ist Fine-Tuning die richtige Wahl, liegt der Aufwand vor allem in der Datenarbeit: Trainingsbeispiele aus Ihrem Bestand aufbereiten, Grenzfälle bewusst aufnehmen, eine Bewertungsmenge davon getrennt halten. Erst danach wird trainiert — und anschliessend gegen genau dieselbe Bewertungsmenge geprüft wie das Ausgangsmodell, damit der Unterschied belegt ist und nicht behauptet.
Ihre Daten bleiben, wo Sie sie haben wollen. Anpassung und Betrieb sind auch vollständig in Ihrer eigenen Infrastruktur möglich, ohne dass Trainings- oder Betriebsdaten das Haus verlassen.
Rahmenbedingungen
| Parameter | Wert |
|---|---|
| Verfahren | Kontextgestaltung, Retrieval über eigene Dokumente, Fine-Tuning |
| Ausgangsmodelle | offene Modelle für den Betrieb in Ihrer Infrastruktur oder gehostete Modelle |
| Datenhaltung | On-Premise oder ausschliesslich in Ihrer Infrastruktur |
| Nachweis der Verbesserung | Vergleich gegen das Ausgangsmodell auf einer getrennt gehaltenen Bewertungsmenge |
| Betrieb | in Ihrer Umgebung oder als von uns betriebener Dienst |
Kundenspezifisch anpassbar
- Aufgabe und Abnahmekriterium gemeinsam festgelegt
- Wahl des Verfahrens: Kontextgestaltung, Retrieval oder Fine-Tuning
- Ausgangsmodell nach Datenschutz-, Kosten- und Qualitätsanforderung
- Aufbereitung der Trainings- und Bewertungsdaten aus Ihrem Bestand
- Datenhoheit: Verarbeitung ausschliesslich in Ihrer Infrastruktur möglich
- Integration in Ihre bestehenden Werkzeuge und Abläufe
- Nachtrainierbarkeit: Werkzeuge und Ablauf für spätere Modellstände
Typische Aufgaben
- Auswertung von Mess- und Prüfprotokollen
- Einordnung von Fehlerbildern und Abweichungen
- Generierung von angepasstem Konfigurations-, Treiber- und Testcode
- Recherche in eigenen Normen, Datenblättern und Altprojekten
- Aufbereitung von Dokumentation aus vorhandenen Unterlagen
MCP-Server und Werkzeuganbindung
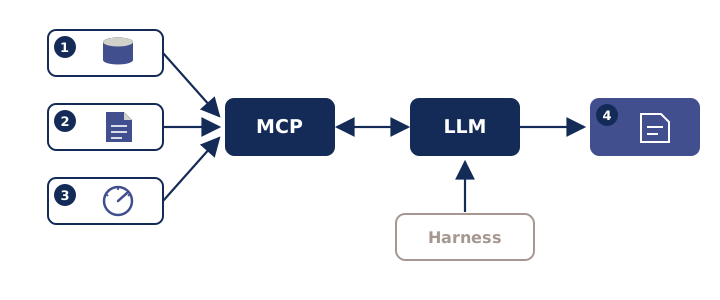
Ein Modell ist erst nützlich, wenn es an die echten Daten und Werkzeuge kommt. Genau das leistet ein MCP-Server.
Das Model Context Protocol (MCP) ist eine offene Schnittstelle, über die ein KI-Modell externe Werkzeuge und Datenquellen ansprechen kann, statt sie in den Prompt kopiert zu bekommen. Wir schreiben die Server, die Ihre Systeme auf dieser Schnittstelle bereitstellen: Messdatenbanken, Prüfstände, Dateiablagen, Versions- und Ticketverwaltung, eigene Berechnungswerkzeuge.
Damit wird aus einem Chatfenster ein Arbeitsplatz: Das Modell liest den aktuellen Messwert, statt danach zu fragen; es öffnet das richtige Datenblatt, statt dessen Inhalt zu erfinden; es legt das Ergebnis dort ab, wo es hingehört. Was es darf und was nicht, legen Sie fest — jedes Werkzeug wird einzeln freigegeben, getrennt nach lesendem und schreibendem Zugriff.
Wir achten dabei auf das, was in der Praxis Probleme macht: klare Rechtegrenzen, nachvollziehbare Protokollierung jedes Werkzeugaufrufs und Werkzeuge, die auch bei unerwarteten Eingaben definiert reagieren statt irgendetwas zu tun.
Umfang
| Parameter | Wert |
|---|---|
| Schnittstelle | Model Context Protocol (MCP), offener Standard |
| Anbindbare Quellen | Datenbanken, Dateiablagen, Prüfstände und Messgeräte, Versions- und Ticketverwaltung, eigene Werkzeuge |
| Rechtevergabe | je Werkzeug einzeln, getrennt nach lesendem und schreibendem Zugriff |
| Protokollierung | jeder Werkzeugaufruf mit Zeitstempel nachvollziehbar |
| Betrieb | in Ihrem Netz; ein Zugriff von aussen ist nicht erforderlich |
Kundenspezifisch anpassbar
- Auswahl und Zuschnitt der bereitgestellten Werkzeuge
- Rechte- und Freigabekonzept, lesend oder schreibend je Werkzeug
- Anbindung an Ihre Datenquellen, Geräte und Prüfstände
- Protokollierung und Auswertung der Zugriffe
- Betrieb im eigenen Netz ohne Zugang von aussen
- Erweiterung um eigene Berechnungs- und Prüfwerkzeuge
Typische Anwendungen
- Zugriff auf Messdaten und Prüfprotokolle ohne Umkopieren
- Recherche in Datenblättern, Normen und Altprojekten
- Automatisches Ablegen von Auswertungen und Berichten
- Anbindung von Prüfständen für Abfrage und Ansteuerung
- Arbeit direkt in Versions- und Ticketverwaltung
KI-Harnesses
Prüfumgebungen, die aus «das Modell wirkt besser» eine belastbare, wiederholbare Zahl machen.
Ein Harness ist die Infrastruktur um ein KI-System herum: Datensätze mit gesicherter Referenz, automatisch berechnete Metriken, versionierte und reproduzierbare Läufe sowie ein Bericht, der zwei Modellstände direkt vergleichbar macht.
Ohne diese Infrastruktur lässt sich ein Modellwechsel nicht verantworten. Man weiss dann nämlich nicht, ob eine Verbesserung im Mittel mit einer Verschlechterung in genau den Fällen erkauft ist, auf die es ankommt. Deshalb gehören Grenz- und Sonderfälle als eigene Testmenge dazu und nicht als Stichprobe im Durchschnitt.
Der Harness läuft automatisiert in Ihrer CI: Jeder Modell- oder Datenstand erzeugt denselben Bericht, und Regressionen fallen auf, bevor sie ausgeliefert werden.
Umfang
| Parameter | Wert |
|---|---|
| Bewertete Systeme | Eigene Modelle, zugekaufte Modelle und LLM-basierte Abläufe |
| Reproduzierbarkeit | Datensätze, Modelle und Konfiguration je Lauf versioniert |
| CI-Anbindung | GitHub Actions, GitLab CI oder Ihre bestehende Pipeline |
| Betrieb | On-Premise oder in Ihrer Cloud-Umgebung |
Kundenspezifisch anpassbar
- Metriken und Abnahmeschwellen nach Ihrem Anwendungsfall
- Aufbau und Pflege der Referenzdatensätze
- Zielsysteme: eigene Modelle, Fremdmodelle, LLM-gestützte Abläufe
- Anbindung an Ihr CI-System
- Berichtsformat und Detailtiefe
- Robustheits- und Grenzfalltests als eigene Testmenge
- Betrieb ausschliesslich in Ihrer Infrastruktur
Typische Anwendungen
- Regressionstests bei Modell- oder Anbieterwechsel
- Abnahme von zugekauften KI-Komponenten
- Laufende Qualitätsüberwachung im Betrieb
- Vergleich mehrerer Modellkandidaten unter gleichen Bedingungen
- Nachweisführung und Dokumentation für Audits
Verwandte Bereiche
Von der Anforderung zur Serie
-
Spezifikation
Wir klären Anwendung, Randbedingungen und Prüfkriterien: Temperaturbereich, Leistung, Messbereich, Einbausituation, Stückzahl, Lebensdauer.
-
Entwurf und Muster
Auslegung, Konstruktion und bemusterte Prototypen — jeweils mit Messprotokoll, damit die Abweichung zur Spezifikation belegt ist und nicht behauptet.
-
Verifikation
Funktions- und Dauerprüfung, thermische Vermessung, EMV-Vorbereitung und Begleitung der Prüfung bis zur Freigabe.
-
Serie
Fertigung der von uns entwickelten Komponenten, elektrische Endprüfung, Dokumentation, Chargenrückverfolgung und Langzeitverfügbarkeit.
Anfrage zu diesem Bereich
Temperaturbereich, Leistung, Messbereich, Einbausituation, Stückzahl — mit diesen Angaben können wir konkret antworten statt allgemein.
Anfrage stellen